写真文字抽出ツール
写真内のハングル・英語をブラウザで読み取り、テキストとしてコピー・保存します。JPG・PNG・WEBP をサポートし、写真と文章をサーバーに送信しません。
写真と言語の選択
写真を選択しない場合、ハングル・英語の公開例を直ち実行します。
公開例 写真表示
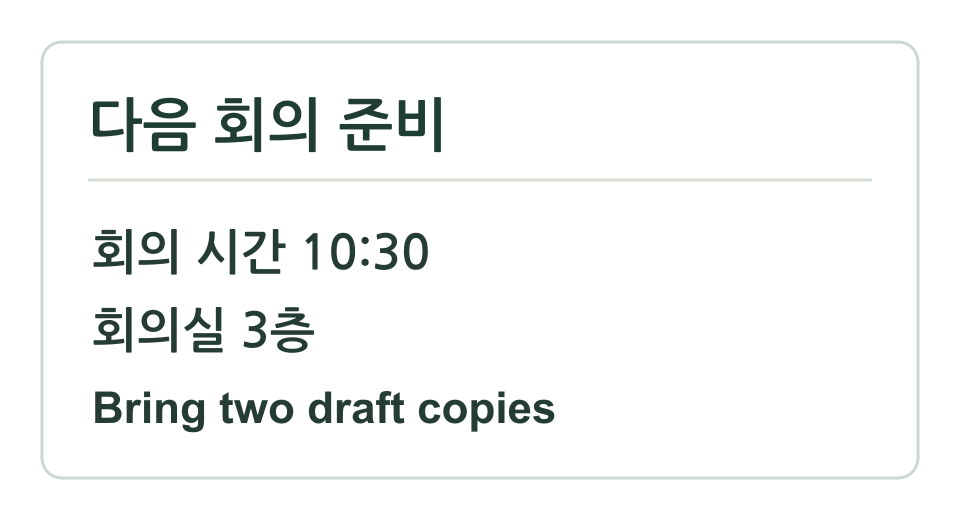
公開例が準備されています。すぐに実行するか、写真を選択してください。
写真と認識された文章はブラウザでのみ処理され、保存・アップロードされません。正確ではない可能性があるため、結果を確認してください。
認識された文字
公開例から韓国語・英語の文章を読むことができます。
ぼやけたり傾いたりした文字、小さな文字、表・多段配列は読み間違いや順序が変わる可能性があります。OCR結果は原本と比較してください。
結果を共有
ツールリンクと結果テキストを一緒に共有します。結果にはURLを入れません。以下の内容を確認して共有してください。
写真の文字抽出方法と例
サンプルには「次の会議の準備」「会議時間 10:30」「会議室 3階」「下書きを2部持参」と書かれています。韓国語と英語を選んで最初に実行すると、写真から読み取った内容が修正可能なテキストで表示されます。
写真を選択し、韓国語・英語または一つの言語を選択した後、「写真から文字を読む」をクリックしてください。最初の実行では、同じサイトからOCRプログラムと選択した言語データをダウンロードできます。その後の処理はブラウザ内で行われ、入力した写真や認識する文章をサーバーに送信しません。
このツールはJPG・PNG・WEBPの静止画像をサポートします。12MB、幅6,000px、1,200万画素を超える元の画像は先に 画像サイズ調整縮小してください。認識前に画像を最大2,200px・400万ドットまで縮小できます。自動回転・傾き補正、手書き文字読み上げ、表構造の復元は提供されません。
よくある質問
写真と認識された文字がサーバーに保存されますか?
申し上げます。OCR処理はブラウザ内で行われます。初回実行に必要なプログラムと言語データはこのサイトからダウンロードされますが、選択した写真や認識文はアップロードや保存されません。結果共有を選択すると、ユーザーが確認したテキストをデバイスの共有メニューやクリップボードに送信できます。
小さな文字や表も正確に読めますか?
文字のサイズ、焦点、傾き、光の反射、背景によって認識結果が異なります。自動回転や傾き補正、表のセル構造の復元は行いません。結果を元のものと比較して修正し、小さな文字は明瞭に撮影するか、先に写真を切り取りましょう。
PDFや手書きも読めますか?
入力はJPG・PNG・WEBPの静止画像です。PDFファイルを直接開きず、手書きの正確な読み取りを保証しません。紙の文書の写真は、文書スキャンツールで補正した画像で再試行できます。
計算基準と参考資料
- Tesseract.js — ブラウザOCR API Workerの設定
ブラウザのWorkerで画像を認識し、worker・core・言語ファイルのパスを同じサイトに固定するAPI。認識結果の正確性は保証されません。
- Tesseract OCR — tessdata_fast言語モデル
韓国語・英語の迅速なLSTMモデルの配布リポジトリとApache-2.0ライセンス。速度を重視したモデルで、認識結果は元のものと比較が必要です。
- MDN — createImageBitmap()
ブラウザでローカル画像データをビットマップ形式にデコーデックし、サイズを調整してキャンバスに描画するAPI。