사진 글자 추출기
사진 속 한글·영어를 브라우저에서 읽고 텍스트로 복사·저장하세요. JPG·PNG·WEBP를 지원하며 사진과 문장을 서버로 보내지 않습니다.
사진과 언어 선택
사진을 고르지 않으면 한글·영어 공개 예시를 바로 실행합니다.
공개 예시 사진 보기
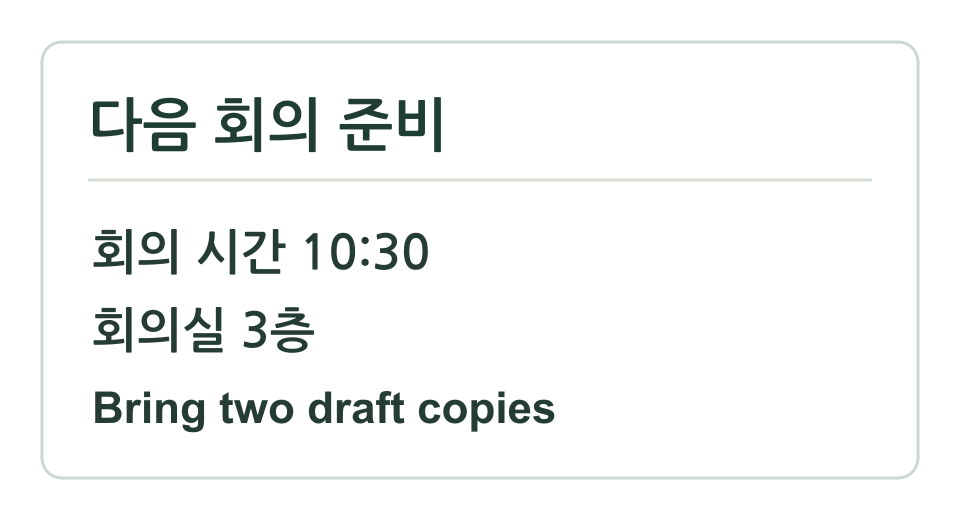
공개 예시가 준비되어 있습니다. 바로 실행하거나 사진을 선택하세요.
사진과 인식한 문장은 브라우저에서만 처리하며 저장·업로드하지 않습니다. 정확하지 않을 수 있으니 결과를 확인하세요.
인식한 글자
공개 예시에서 한글·영어 문장을 읽을 수 있습니다.
흐리거나 기울어진 글자, 작은 글씨, 표·다단 배열은 잘못 읽거나 순서가 달라질 수 있습니다. OCR 결과는 원본과 대조하세요.
결과 공유
도구 링크와 결과 텍스트를 함께 공유합니다. 결과는 URL에 넣지 않습니다. 아래 내용을 확인하고 공유하세요.
사진 글자 추출 방법과 예시
공개 예시에는 ‘다음 회의 준비’, ‘회의 시간 10:30’, ‘회의실 3층’, ‘Bring two draft copies’가 적혀 있습니다. 한국어+영어를 선택해 첫 실행하면 사진에서 실제로 읽은 결과를 교정 가능한 텍스트로 보여줍니다.
사진을 선택하고 한국어·영어 또는 한 언어를 고른 뒤 ‘사진에서 글자 읽기’를 누르세요. 첫 실행에는 같은 사이트에서 OCR 프로그램과 선택한 언어 자료를 내려받을 수 있습니다. 이후 처리는 브라우저 안에서 이뤄지며 입력 사진이나 인식 문장을 서버로 보내지 않습니다.
이 도구는 JPG·PNG·WEBP 정지 이미지를 지원합니다. 12MB, 한 변 6,000px, 1,200만 화소를 넘는 원본은 먼저 이미지 크기 조절에서 줄여 주세요. 인식 전에 이미지를 최대 2,200px·400만 화소로 축소할 수 있습니다. 자동 회전·기울기 보정, 손글씨 판독, 표 구조 복원은 제공하지 않습니다.
자주 묻는 질문
사진과 인식한 글자가 서버에 저장되나요?
아닙니다. OCR 처리는 브라우저 안에서 이뤄집니다. 첫 실행에 필요한 프로그램과 언어 자료는 이 사이트에서 내려받지만 선택한 사진과 인식 문장은 업로드하거나 저장하지 않습니다. 결과 공유를 선택하면 사용자가 확인한 텍스트를 기기의 공유 메뉴나 클립보드로 보낼 수 있습니다.
작은 글씨와 표도 정확하게 읽나요?
글자 크기·초점·기울기·빛 반사·배경에 따라 인식 결과가 달라집니다. 자동 회전과 기울기 보정, 표 셀 구조 복원은 하지 않습니다. 결과를 원본과 비교해 고치고, 작은 글씨는 선명하게 촬영하거나 사진을 먼저 자르세요.
PDF나 손글씨도 읽을 수 있나요?
입력은 JPG·PNG·WEBP 정지 이미지입니다. PDF 파일을 직접 열지 않으며 손글씨의 정확한 판독을 보장하지 않습니다. 종이 문서 사진은 문서 스캔 도구에서 보정한 이미지로 다시 시도할 수 있습니다.
계산 기준과 참고 자료
- Tesseract.js — 브라우저 OCR API와 Worker 설정
브라우저 Worker에서 이미지를 인식하고 worker·core·언어 파일 경로를 같은 사이트로 고정하는 API. 인식 결과의 정확도를 보장하지 않습니다.
- Tesseract OCR — tessdata_fast 언어 모델
한국어·영어 빠른 LSTM 모델의 배포 저장소와 Apache-2.0 라이선스. 속도 중심 모델이며 인식 결과는 원본 대조가 필요합니다.
- MDN — createImageBitmap()
브라우저에서 로컬 이미지 데이터를 비트맵으로 디코딩해 크기를 조정하여 캔버스에 그리는 API.